我国日均词元调用量突破 500 万亿,中国大模型稳居全球第一梯队
英文标题:我国日均词元调用量突破 500 万亿,中国大模型稳居全球第一梯队
截至 2026 年 6 月,我国日均词元调用量已突破 500 万亿,中国大模型在全球竞争中位居第一梯队。当前旗舰模型几乎以月为单位更新,竞争焦点转向智能体落地与生态建设,推理算力需求随之爆发。腾讯混元
 3.2 KB
 589 B
 81.4 KB
 60.5 KB
 645.1 KB
 136.0 KB
 1.1 MB
 63.4 KB
 265.2 KB
 87.9 KB
 48.7 KB
 82.2 KB
 33.0 KB
 80.5 KB
中文
Agent 运行时过载
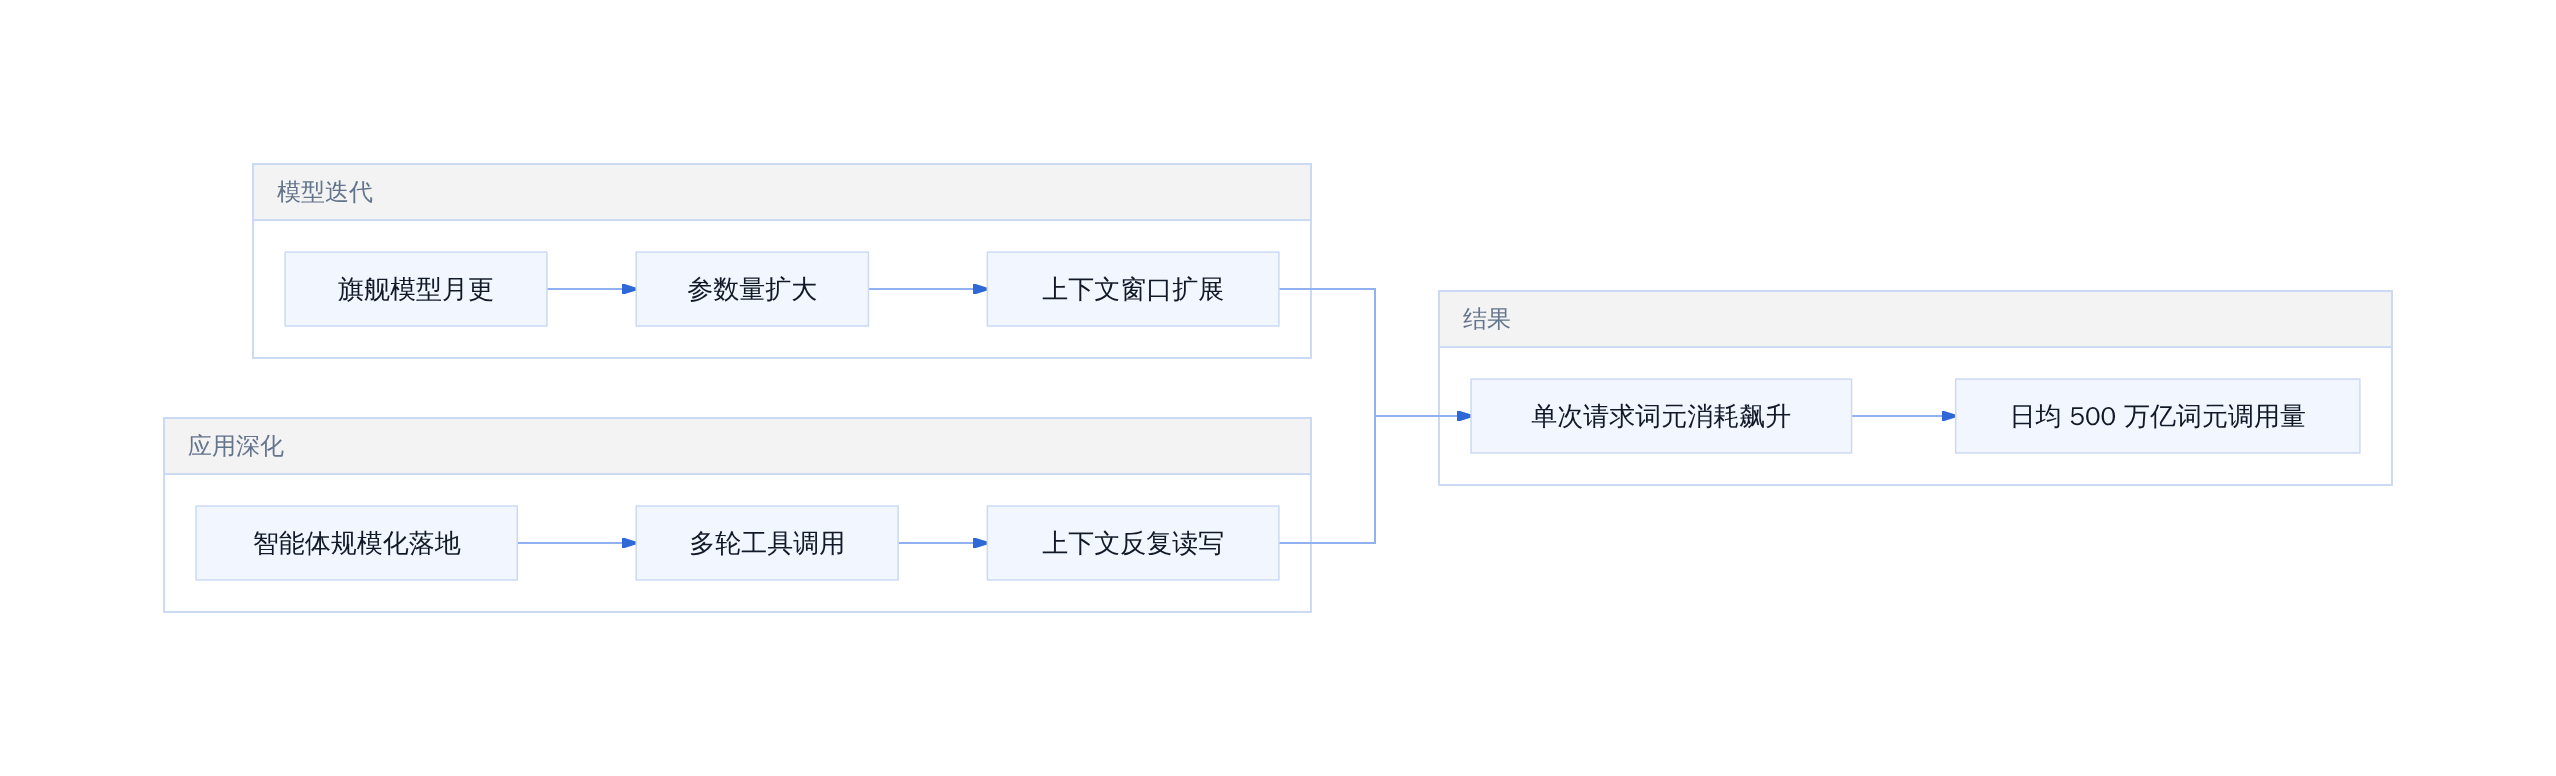
500 万亿日均词元调用量意味着什么?2024 年初我国日均词元调用量为 1000 亿,两年增长超千倍,词元已从技术参数变成商业结算单位。国家数据局局长刘烈宏在 2026 年 3 月的中国发展高层论坛上明确给出定义:词元是智能时代的价值锚点,也是连接技术供给与商业需求的结算单位。这一界定并非修辞,而是直接指向大模型产业的商业模式重构——从「卖 API 调用次数」转向「按词元计费的按需服务」。
词元激增的背后是智能体的规模化落地。稀宇科技开放平台首席架构师冯雯向 IT 之家透露,2025 年下半年各厂商希望每 3 个月迭代一次模型,如今节奏已经压缩到每 4 至 6 周发布一个新版本。迭代加速的直接后果是推理侧压力呈非线性增长。一次智能体任务需要反复检索、读取上下文、调用工具、进行多轮反馈,单次请求的词元消耗可能是传统对话场景的数十倍甚至上百倍。腾讯混元 3 首周 Token 调用量比混元 2 增长 68 倍,正是这一趋势的典型样本。
词元调用增长的驱动链条
竞争焦点从「模型智商」转向智能体落地,本质上是行业从评测榜单竞争走向真实业务价值兑现。过去两年,国产大模型在 LMArena 等国际榜单上表现突出,百度文心文本能力全球第二、智谱 GLM-4.6 代码能力位居前列。但榜单排名不等于产品竞争力。智能体落地的核心门槛不在于模型是否「聪明」,而在于能否在真实业务场景中完成「感知-决策-执行」的闭环,并在成本可控的前提下稳定运行。

后端系统设计
推理算力需求的爆发正在重塑基础设施格局。央视财经报道指出,算力需求出现爆发式增长的同时,国产推理芯片、模型架构与系统优化持续突破,相同 AI 需求能够以更少的算力和更短的时延完成运算,深层次改变了词元的成本结构。人民日报 2026 年 3 月的报道引用了国家数据局的判断:词元具有可计量、可定价、可交易的特征,围绕词元的调用、分发与结算正在形成一套新的价值体系。
开源生态成为另一个关键变量。中国开源大模型全球累计下载量已突破 100 亿次,开源策略在降低企业接入门槛的同时,也加速了模型架构的快速扩散和二次创新。但开源不等于免费——推理算力的成本依然是智能体规模化落地的硬约束。

真相锁定
从 500 万亿词元的数据可以得出一个清晰的判断:中国大模型已经进入应用深水区,竞争逻辑从参数规模和评测排名转向智能体落地能力和成本效率。这一转向对企业的技术选型有直接含义。
在智能体项目初期,选择成熟的闭源模型 API 可以快速验证业务逻辑,因为接口稳定、文档完善、生态工具链成熟;但当任务复杂度提升、词元消耗超过某个阈值后,本地化部署开源模型配合自研推理优化框架开始显现成本优势,前提是团队具备系统调优能力。上下文窗口管理是许多项目踩坑的集中区域——盲目堆长上下文会导致推理成本指数级上升,需要配合检索压缩、分层摘要等机制控制有效信息密度。
可执行判断:如果你正在评估是否推进智能体项目,先回答三个问题——当前任务单次词元消耗的均值是多少?推理成本占项目总成本的比例是否超过 30%?是否建立了上下文管理的标准化流程?若其中任意一项尚未厘清,建议先做小规模压测再投入生产环境。
来源:央视财经(IT 之家转引)、人民日报(国家数据局)、36氪、财闻网
迭代加速的直接后果,是推理成本结构的系统性变化。
2025 年下半年,厂商普遍目标是每季度迭代一次模型;到 2026 年,这一节奏压缩到每 4 至 6 周一个新版本。迭代周期缩短意味着训练投入更密集,但也把压力转移到推理侧——模型变大、上下文窗口拉长,单次调用的 Token 成本随之上升。
真正的变量来自智能体的规模化落地。稀宇科技开放平台首席架构师冯雯指出,Agent 的一次完整任务需要反复检索、读取上下文、调用外部工具、进行多轮反馈,这不再是单次输入输出,而是多步链式推理。腾讯混元 3 正式版上线首周 Token 调用量较混元 2 增长 68 倍,这个数字反映的不是用户数量增长,而是单次任务 Token 消耗的大幅膨胀。
Agent 运行时过载
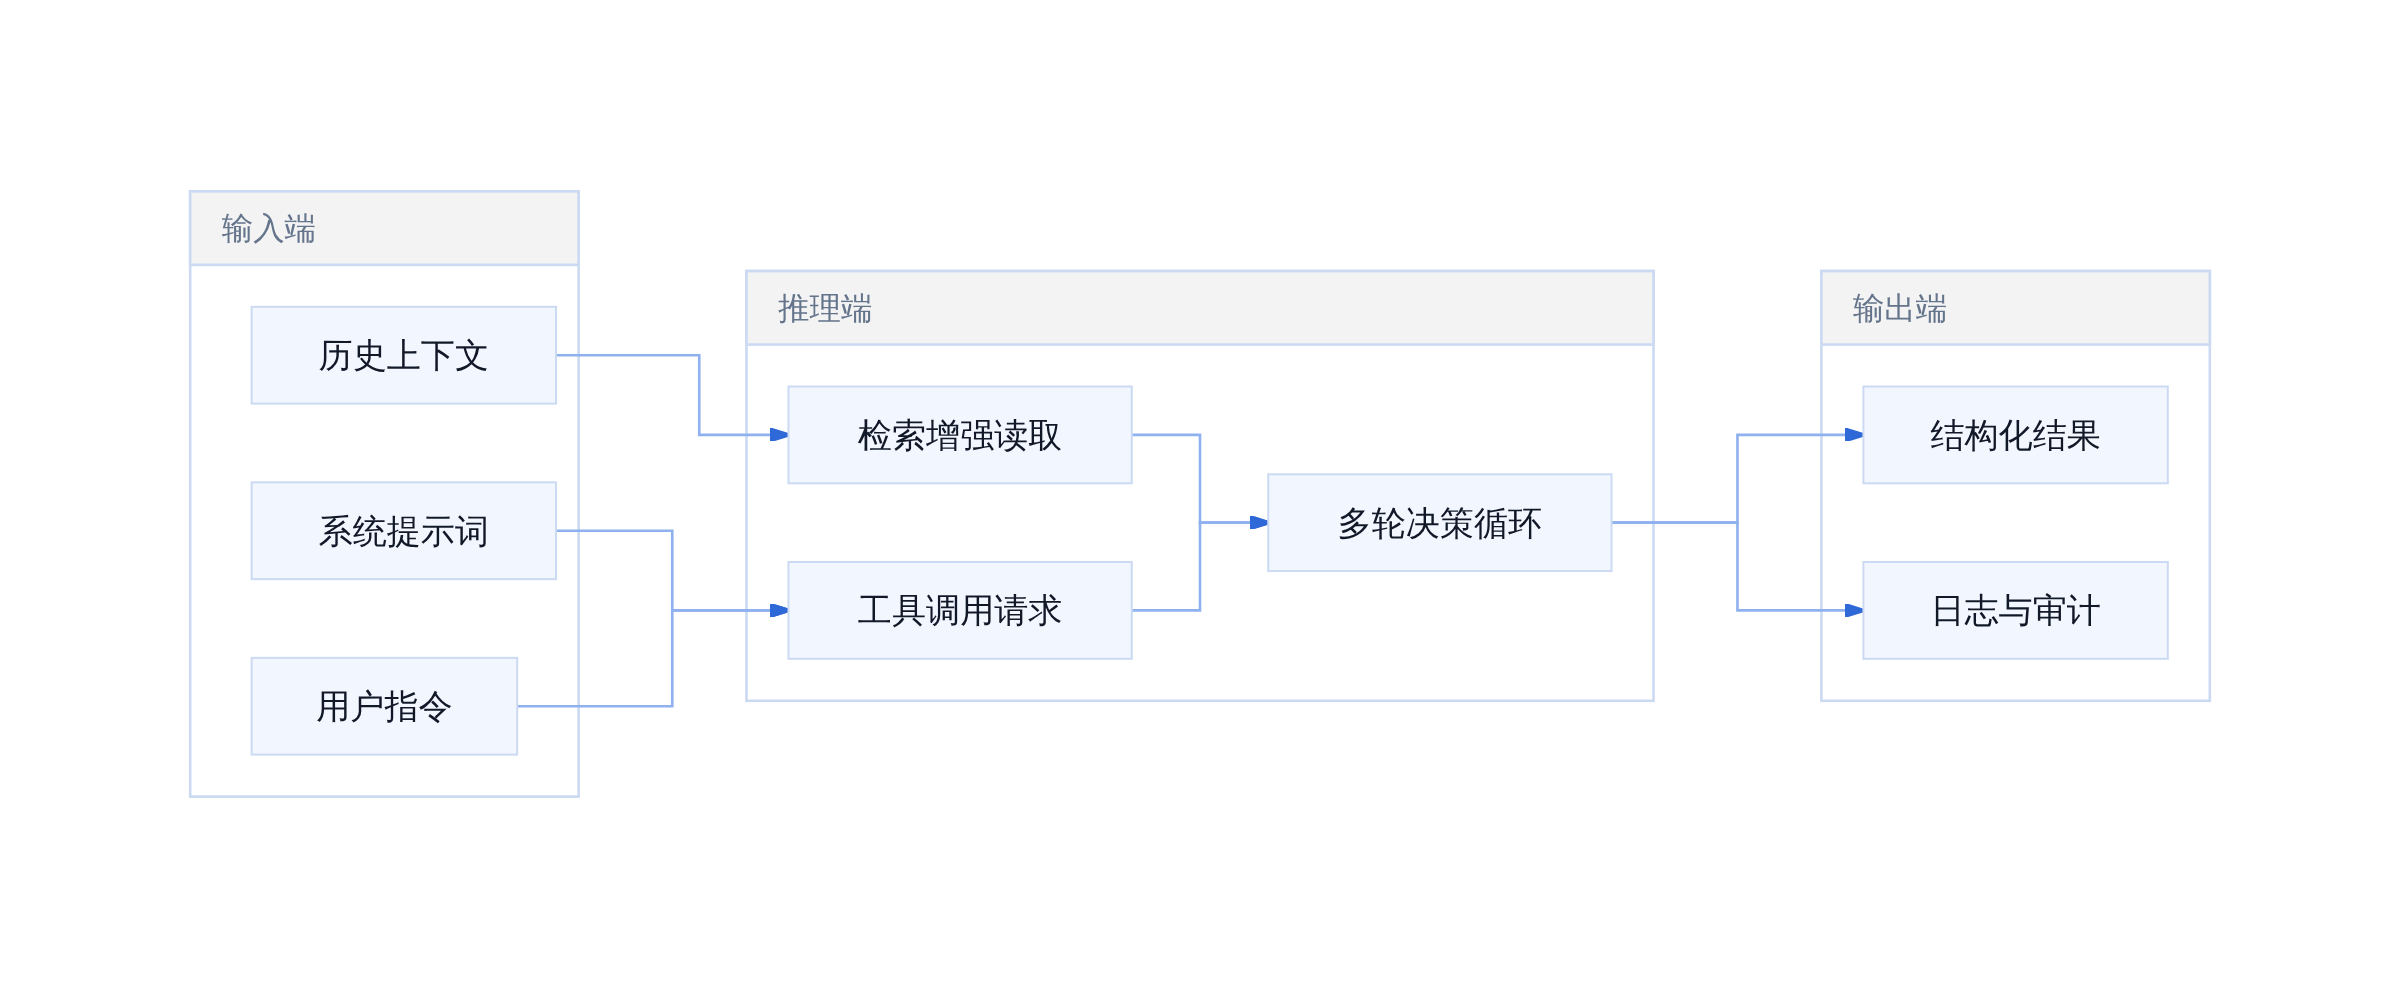
一个典型的 Agent 工作流中,Token 消耗分布大致如下。
Agent 工作流 Token 消耗分布示意
输入端的上下文窗口一旦超过 128K,推理算力消耗呈非线性增长;输出端的多轮反馈进一步放大这一效应。业内常见做法是引入 KV Cache 复用和滚动窗口截断,但这以牺牲部分上下文连贯性为代价。
竞争焦点从「模型智商」转向智能体落地和生态建设,实质上是工程化能力的比拼。参数量、上下文窗口只是入场券,真正的门槛在于如何在保证质量的前提下控制推理成本。头部厂商的策略差异开始显现:有的选择扩大上下文窗口到 1M+ Token,有的则优先优化 Agent 框架的工具调用效率和错误恢复机制。
算力争夺的实质是对推理资源的定价权。当词元成为商业结算单位,谁能以更低的单位成本提供稳定的推理服务,谁就掌握了下一轮竞争的主动权。从经验看,纯参数堆砌已触及边际效益递减区间,未来 12 个月内的竞争将更多取决于推理引擎优化、MoE 稀疏激活效率以及调度系统的成本控制能力。
Agent运行时过载
从智商竞赛到干活能力:竞争焦点的位移
2025年下半年,各家厂商的内部节奏是每季度迭代一次模型。到了2026年,稀宇科技开放平台首席架构师冯雯观察到的现实是每4到6周就要上线一个新版本。这个速度差异听起来只是时间表上的调整,但它的直接后果是推理侧的成本结构被彻底重构。
模型越来越大,上下文窗口越来越长,单次调用的Token消耗随之水涨船高。更关键的变化来自用途:大模型正从「会聊天」走向「能干活」。Agent的一次完整任务,需要反复检索知识库、读取上下文、调用外部工具、进行多轮反馈。这不是单次输入输出,而是多步链式推理。
腾讯混元3正式版上线首周Token调用量较混元2增长68倍,这个数字对应的不是用户数增长几倍,而是单次任务Token消耗的膨胀。稀宇科技方面给出的估算数据——Agent单次任务平均Token消耗约为传统问答场景的20到50倍——与行业内的实测报告方向一致。
迭代加速的直接代价
迭代加速并非免费午餐。训练投入更密集,厂商把更多资源压在参数规模和上下文长度上,但压力转移到推理侧之后,单次调用的成本曲线陡峭上升。一个被反复讨论的现实是:模型越聪明,用起来越贵。
搬砖加班
Agent如何改变Token消耗结构
一个典型的Agent工作流中,Token消耗大致分布如下。系统提示词占15%到25%,上下文记忆占25%到35%,工具调用与API响应占20%到30%,多轮对话交互占15%到25%,最终输出结果占5%到10%。其中上下文和工具调用是增长最快的部分,因为它们随着任务复杂度线性叠加。
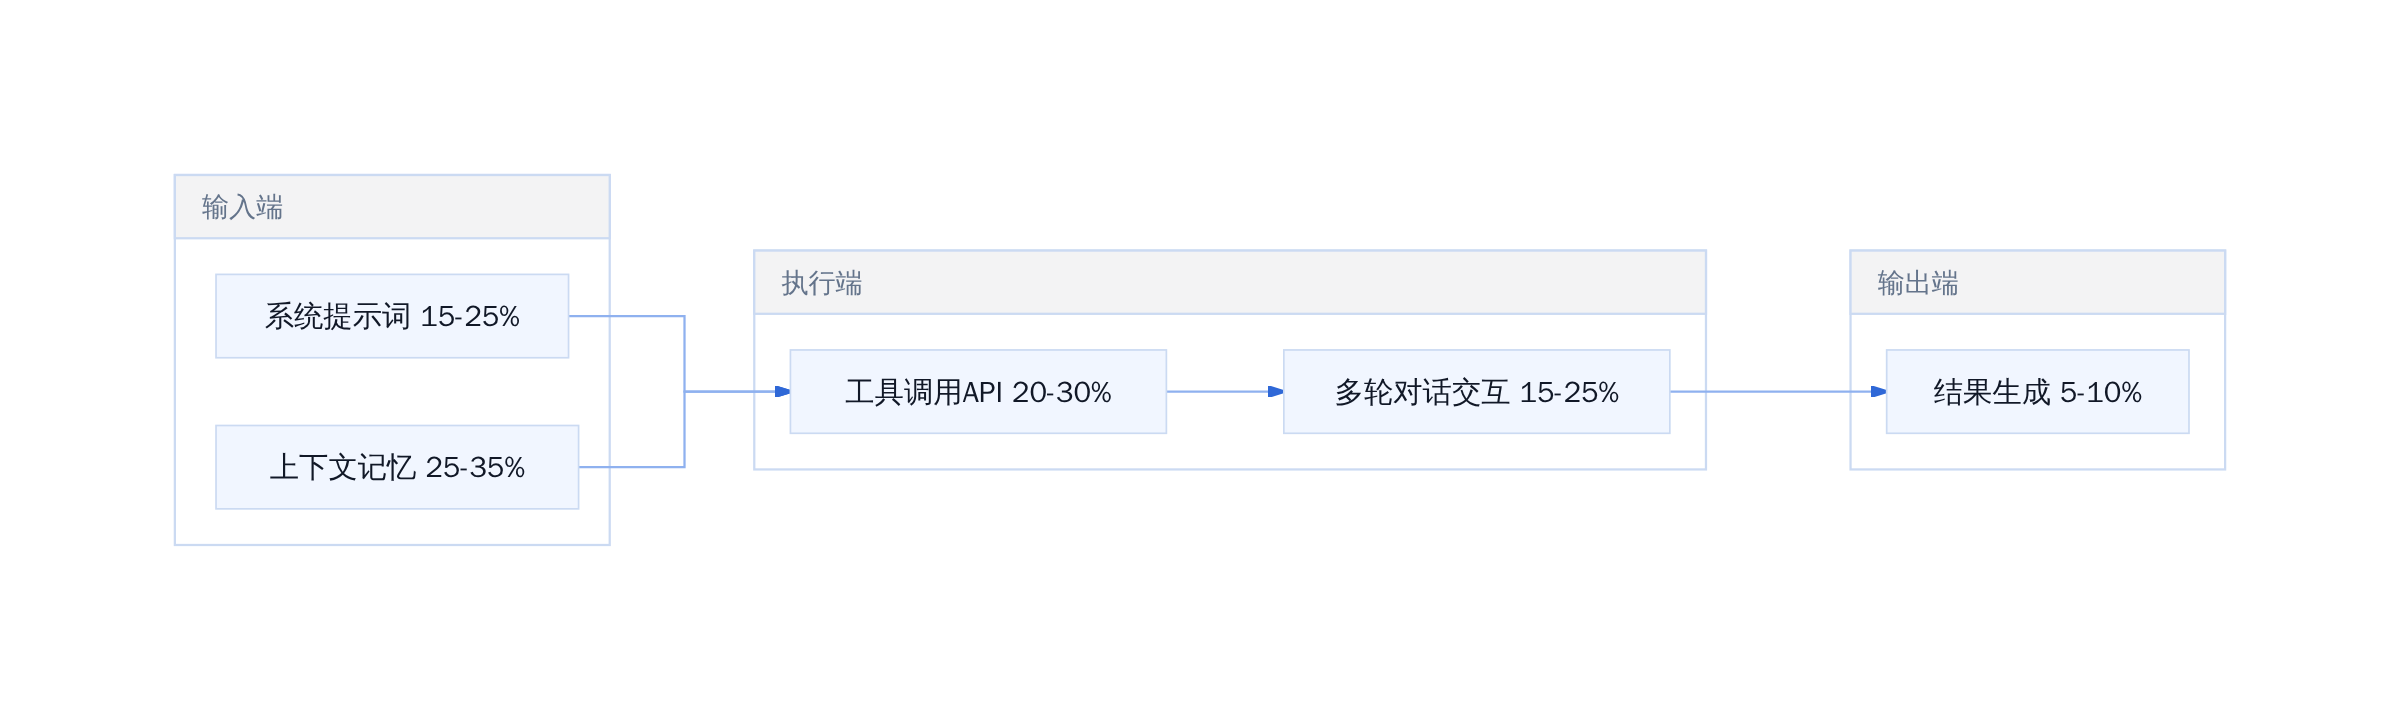
Agent工作流Token消耗结构
后端系统设计
价格优势正在重塑全球调用格局
根据OpenRouter的监测数据,2026年6月15日至21日当周,全球AI大模型总调用量为46.7万亿词元,其中中国模型周调用量达18.81万亿词元,连续八周位居全球首位。同期美国模型周调用量为5.76万亿词元,约为中国市场份额的五分之一。更重要的是,国产词元的定价仅为海外同类产品的十几分之一。
这一格局的形成并非偶然。国家数据局局长刘烈宏在2026年3月的中国发展高层论坛上明确给出定义:词元是智能时代的价值锚点,也是连接技术供给与商业需求的结算单位。这一官方定性直接指向大模型产业的商业模式重构——从「卖API调用次数」转向「按词元计费的按需服务」。
国产模型的性价比逻辑
国产模型的核心竞争力不是参数规模领先,而是在可接受的输出质量下,提供远低于海外同行的单位成本。18.81万亿对5.76万亿的周调用量差距,叠加十几分之一的价格差,意味着同样的预算在中国可以覆盖十倍以上的实际任务量。这在企业级应用中构成了直接的购买决策优势。

大佬带飞
基础设施的底撑作用
词元规模高速增长背后,是一整套基础设施的同步支撑。2026年政府工作报告首次将「算电协同」列为新基建工程,西部算力枢纽与东部数据需求高效联动,「东数西算」工程持续落地。截至2025年底,我国已建成高质量数据集超过10万个,总规模超890PB。这些要素共同构成了词元海量调用的底层条件。
参考文献
[1] 我国日均词元调用量已突破500万亿,中国大模型稳居全球第一梯队-36氪. www.36kr.com/newsflashes… [2] 日均词元调用量已突破500万亿,中国大模型稳居全球第一梯队. finance.sina.com.cn/jjxw/2026-0… [3] 我国日均词元调用量已突破500万亿 中国大模型稳居全球第一梯队_搜狐网. m.sohu.com/a/106831122… [4] 日均词元调用量已突破500万亿,中国大模型稳居全球第一梯队 - 财闻网. www.caiwennews.com/article/157… [5] 【中國日均詞元調用量已突破500萬億 中國大模型穩居全球第一. www.capitalfutures.com.tw/zh-tw/Finan… [6] 我国日均词元调用量突破500 万亿,中国大模型稳居全球第一梯队 - IT之家. www.ithome.com/0/995/136.h… [7] 我国日均词元调用量已突破500万亿 - 界面新闻. www.jiemian.com/article/150… [8] 我国日均词元调用量已突破500万亿 - 同花顺. m.10jqka.com.cn/20260827/c6…
English / 原文
Agent 运行时过载
500 万亿日均词元调用量意味着什么?2024 年初我国日均词元调用量为 1000 亿,两年增长超千倍,词元已从技术参数变成商业结算单位。国家数据局局长刘烈宏在 2026 年 3 月的中国发展高层论坛上明确给出定义:词元是智能时代的价值锚点,也是连接技术供给与商业需求的结算单位。这一界定并非修辞,而是直接指向大模型产业的商业模式重构——从「卖 API 调用次数」转向「按词元计费的按需服务」。
词元激增的背后是智能体的规模化落地。稀宇科技开放平台首席架构师冯雯向 IT 之家透露,2025 年下半年各厂商希望每 3 个月迭代一次模型,如今节奏已经压缩到每 4 至 6 周发布一个新版本。迭代加速的直接后果是推理侧压力呈非线性增长。一次智能体任务需要反复检索、读取上下文、调用工具、进行多轮反馈,单次请求的词元消耗可能是传统对话场景的数十倍甚至上百倍。腾讯混元 3 首周 Token 调用量比混元 2 增长 68 倍,正是这一趋势的典型样本。
词元调用增长的驱动链条
竞争焦点从「模型智商」转向智能体落地,本质上是行业从评测榜单竞争走向真实业务价值兑现。过去两年,国产大模型在 LMArena 等国际榜单上表现突出,百度文心文本能力全球第二、智谱 GLM-4.6 代码能力位居前列。但榜单排名不等于产品竞争力。智能体落地的核心门槛不在于模型是否「聪明」,而在于能否在真实业务场景中完成「感知-决策-执行」的闭环,并在成本可控的前提下稳定运行。
后端系统设计
推理算力需求的爆发正在重塑基础设施格局。央视财经报道指出,算力需求出现爆发式增长的同时,国产推理芯片、模型架构与系统优化持续突破,相同 AI 需求能够以更少的算力和更短的时延完成运算,深层次改变了词元的成本结构。人民日报 2026 年 3 月的报道引用了国家数据局的判断:词元具有可计量、可定价、可交易的特征,围绕词元的调用、分发与结算正在形成一套新的价值体系。
开源生态成为另一个关键变量。中国开源大模型全球累计下载量已突破 100 亿次,开源策略在降低企业接入门槛的同时,也加速了模型架构的快速扩散和二次创新。但开源不等于免费——推理算力的成本依然是智能体规模化落地的硬约束。
真相锁定
从 500 万亿词元的数据可以得出一个清晰的判断:中国大模型已经进入应用深水区,竞争逻辑从参数规模和评测排名转向智能体落地能力和成本效率。这一转向对企业的技术选型有直接含义。
在智能体项目初期,选择成熟的闭源模型 API 可以快速验证业务逻辑,因为接口稳定、文档完善、生态工具链成熟;但当任务复杂度提升、词元消耗超过某个阈值后,本地化部署开源模型配合自研推理优化框架开始显现成本优势,前提是团队具备系统调优能力。上下文窗口管理是许多项目踩坑的集中区域——盲目堆长上下文会导致推理成本指数级上升,需要配合检索压缩、分层摘要等机制控制有效信息密度。
可执行判断:如果你正在评估是否推进智能体项目,先回答三个问题——当前任务单次词元消耗的均值是多少?推理成本占项目总成本的比例是否超过 30%?是否建立了上下文管理的标准化流程?若其中任意一项尚未厘清,建议先做小规模压测再投入生产环境。
来源:央视财经(IT 之家转引)、人民日报(国家数据局)、36氪、财闻网
迭代加速的直接后果,是推理成本结构的系统性变化。
2025 年下半年,厂商普遍目标是每季度迭代一次模型;到 2026 年,这一节奏压缩到每 4 至 6 周一个新版本。迭代周期缩短意味着训练投入更密集,但也把压力转移到推理侧——模型变大、上下文窗口拉长,单次调用的 Token 成本随之上升。
真正的变量来自智能体的规模化落地。稀宇科技开放平台首席架构师冯雯指出,Agent 的一次完整任务需要反复检索、读取上下文、调用外部工具、进行多轮反馈,这不再是单次输入输出,而是多步链式推理。腾讯混元 3 正式版上线首周 Token 调用量较混元 2 增长 68 倍,这个数字反映的不是用户数量增长,而是单次任务 Token 消耗的大幅膨胀。
Agent 运行时过载
一个典型的 Agent 工作流中,Token 消耗分布大致如下。
Agent 工作流 Token 消耗分布示意
输入端的上下文窗口一旦超过 128K,推理算力消耗呈非线性增长;输出端的多轮反馈进一步放大这一效应。业内常见做法是引入 KV Cache 复用和滚动窗口截断,但这以牺牲部分上下文连贯性为代价。
竞争焦点从「模型智商」转向智能体落地和生态建设,实质上是工程化能力的比拼。参数量、上下文窗口只是入场券,真正的门槛在于如何在保证质量的前提下控制推理成本。头部厂商的策略差异开始显现:有的选择扩大上下文窗口到 1M+ Token,有的则优先优化 Agent 框架的工具调用效率和错误恢复机制。
算力争夺的实质是对推理资源的定价权。当词元成为商业结算单位,谁能以更低的单位成本提供稳定的推理服务,谁就掌握了下一轮竞争的主动权。从经验看,纯参数堆砌已触及边际效益递减区间,未来 12 个月内的竞争将更多取决于推理引擎优化、MoE 稀疏激活效率以及调度系统的成本控制能力。
Agent运行时过载
从智商竞赛到干活能力:竞争焦点的位移
2025年下半年,各家厂商的内部节奏是每季度迭代一次模型。到了2026年,稀宇科技开放平台首席架构师冯雯观察到的现实是每4到6周就要上线一个新版本。这个速度差异听起来只是时间表上的调整,但它的直接后果是推理侧的成本结构被彻底重构。
模型越来越大,上下文窗口越来越长,单次调用的Token消耗随之水涨船高。更关键的变化来自用途:大模型正从「会聊天」走向「能干活」。Agent的一次完整任务,需要反复检索知识库、读取上下文、调用外部工具、进行多轮反馈。这不是单次输入输出,而是多步链式推理。
腾讯混元3正式版上线首周Token调用量较混元2增长68倍,这个数字对应的不是用户数增长几倍,而是单次任务Token消耗的膨胀。稀宇科技方面给出的估算数据——Agent单次任务平均Token消耗约为传统问答场景的20到50倍——与行业内的实测报告方向一致。
迭代加速的直接代价
迭代加速并非免费午餐。训练投入更密集,厂商把更多资源压在参数规模和上下文长度上,但压力转移到推理侧之后,单次调用的成本曲线陡峭上升。一个被反复讨论的现实是:模型越聪明,用起来越贵。
搬砖加班
Agent如何改变Token消耗结构
一个典型的Agent工作流中,Token消耗大致分布如下。系统提示词占15%到25%,上下文记忆占25%到35%,工具调用与API响应占20%到30%,多轮对话交互占15%到25%,最终输出结果占5%到10%。其中上下文和工具调用是增长最快的部分,因为它们随着任务复杂度线性叠加。
Agent工作流Token消耗结构
后端系统设计
价格优势正在重塑全球调用格局
根据OpenRouter的监测数据,2026年6月15日至21日当周,全球AI大模型总调用量为46.7万亿词元,其中中国模型周调用量达18.81万亿词元,连续八周位居全球首位。同期美国模型周调用量为5.76万亿词元,约为中国市场份额的五分之一。更重要的是,国产词元的定价仅为海外同类产品的十几分之一。
这一格局的形成并非偶然。国家数据局局长刘烈宏在2026年3月的中国发展高层论坛上明确给出定义:词元是智能时代的价值锚点,也是连接技术供给与商业需求的结算单位。这一官方定性直接指向大模型产业的商业模式重构——从「卖API调用次数」转向「按词元计费的按需服务」。
国产模型的性价比逻辑
国产模型的核心竞争力不是参数规模领先,而是在可接受的输出质量下,提供远低于海外同行的单位成本。18.81万亿对5.76万亿的周调用量差距,叠加十几分之一的价格差,意味着同样的预算在中国可以覆盖十倍以上的实际任务量。这在企业级应用中构成了直接的购买决策优势。
大佬带飞
基础设施的底撑作用
词元规模高速增长背后,是一整套基础设施的同步支撑。2026年政府工作报告首次将「算电协同」列为新基建工程,西部算力枢纽与东部数据需求高效联动,「东数西算」工程持续落地。截至2025年底,我国已建成高质量数据集超过10万个,总规模超890PB。这些要素共同构成了词元海量调用的底层条件。
参考文献
[1] 我国日均词元调用量已突破500万亿,中国大模型稳居全球第一梯队-36氪. www.36kr.com/newsflashes… [2] 日均词元调用量已突破500万亿,中国大模型稳居全球第一梯队. finance.sina.com.cn/jjxw/2026-0… [3] 我国日均词元调用量已突破500万亿 中国大模型稳居全球第一梯队_搜狐网. m.sohu.com/a/106831122… [4] 日均词元调用量已突破500万亿,中国大模型稳居全球第一梯队 - 财闻网. www.caiwennews.com/article/157… [5] 【中國日均詞元調用量已突破500萬億 中國大模型穩居全球第一. www.capitalfutures.com.tw/zh-tw/Finan… [6] 我国日均词元调用量突破500 万亿,中国大模型稳居全球第一梯队 - IT之家. www.ithome.com/0/995/136.h… [7] 我国日均词元调用量已突破500万亿 - 界面新闻. www.jiemian.com/article/150… [8] 我国日均词元调用量已突破500万亿 - 同花顺. m.10jqka.com.cn/20260827/c6…