Google DeepMind 将 AI 科学家 Co-Scientist 扩展为实验室集成研究伙伴
英文标题:Google DeepMind 将 AI 科学家 Co-Scientist 扩展为实验室集成研究伙伴
Google DeepMind 将多智能体系统 Co-Scientist 从假设生成器扩展为实验室集成研究伙伴,可规划实验、编写代码、控制设备并生成论文。该系统在材料科学、生物学和计算机科学三领域获实
 3.2 KB
 589 B
 81.4 KB
 126.0 KB
 42.7 KB
 1.2 MB
 948.5 KB
 187.1 KB
 411.3 KB
 517.2 KB
 59.4 KB
 260.3 KB
 82.2 KB
 140.2 KB
 47.1 KB
 507.3 KB
 211.8 KB
 80.5 KB
中文
Agent 多角色协作时的系统负载
从假设到闭环:Co-Scientist 的能力跃迁
Co-Scientist 的核心突破在于从单一环节的工具演化为端到端的研究闭环。早期版本仅负责文献检索与假设生成,研究者拿到假设后仍需手动设计实验、执行验证。现在的版本将这一链条打通:给定自然语言描述的研究目标,系统能拆解任务、规划实验路径、生成可执行代码,并在特定实验室环境中直接控制仪器设备采集数据,最终自动整理为论文初稿。
多智能体协作架构
这一能力并非来自单一模型的升级,而是多智能体分工协作的结果。系统内部包含多个专用 Agent:文献搜索 Agent 负责召回相关论文与数据;假设生成 Agent 基于证据链提出可验证的假设;实验设计 Agent 将假设转化为具体操作步骤;代码执行 Agent 负责编写和运行模拟程序;论文撰写 Agent 则将结果结构化输出。各 Agent 之间存在辩论与校验机制,避免单一视角导致的系统性偏差。
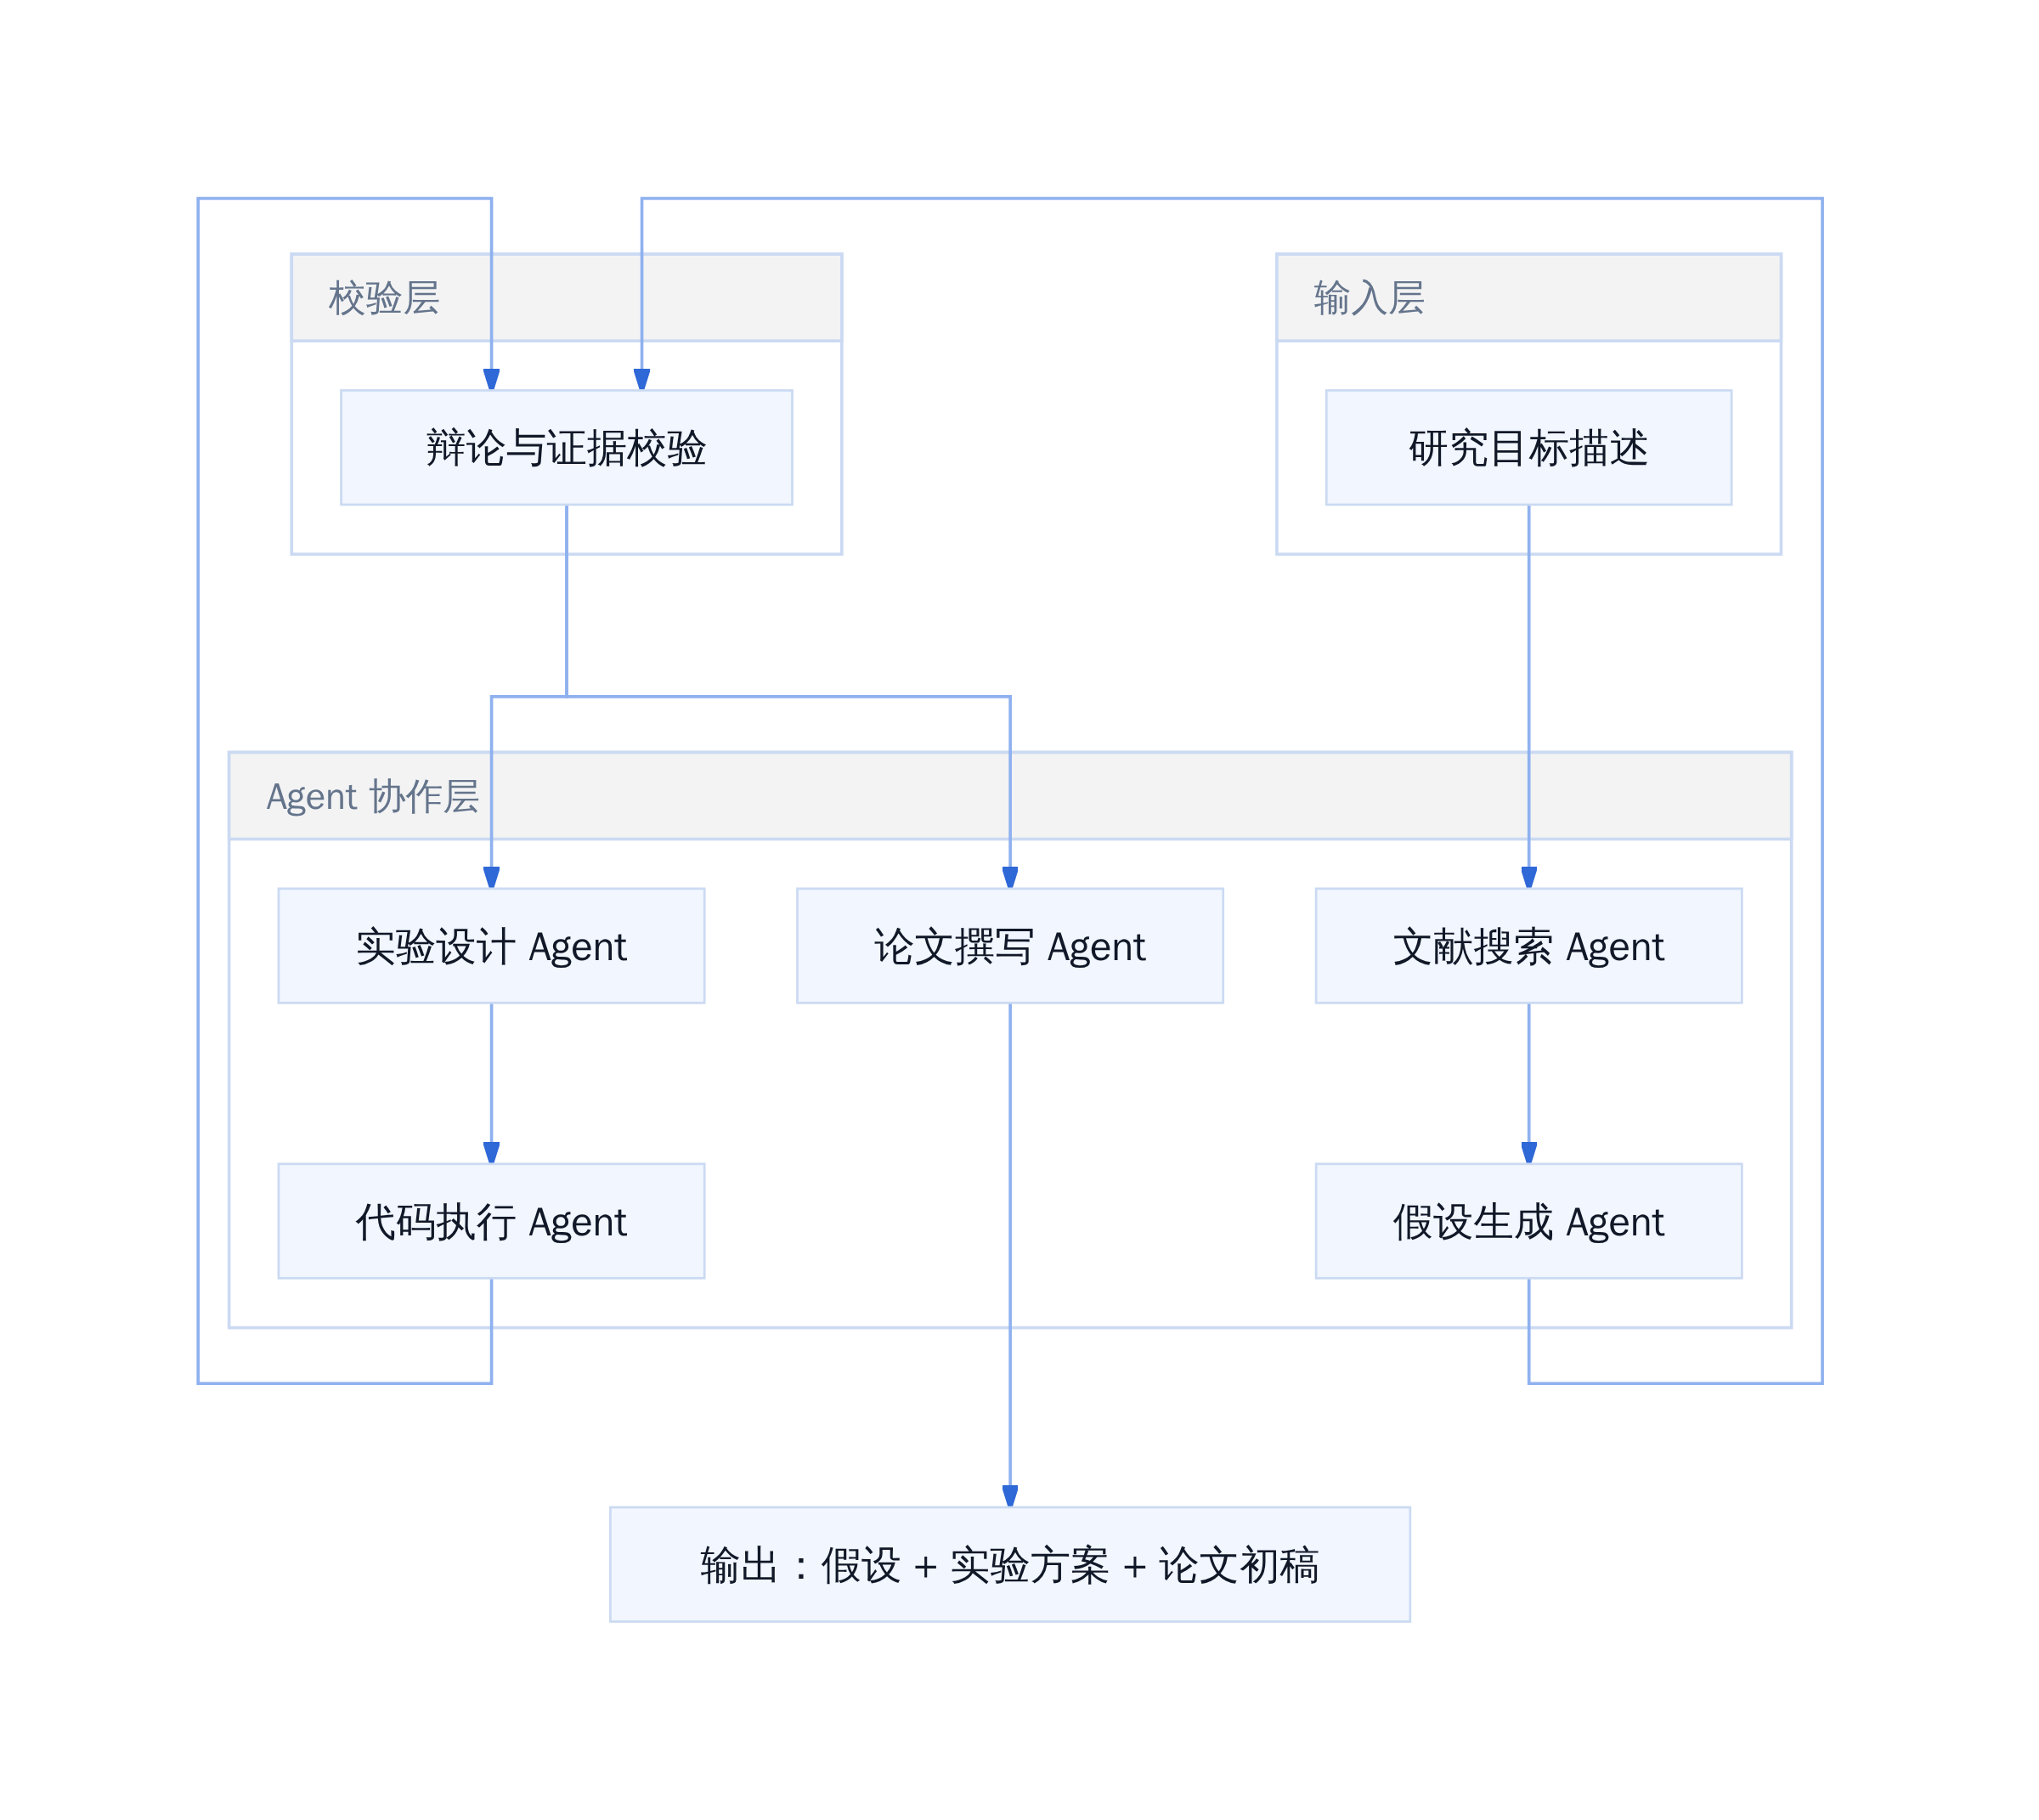
Co-Scientist 多智能体协作架构
实验室集成能力
实验室集成是此次扩展中最具实质意义的改动。系统不再仅限于数字世界的文献与代码,而是通过 API 接入真实实验设备,包括高通量筛选仪器、自动化液体处理工作站和数据采集传感器。这意味着在材料科学领域,Co-Scientist 可以直接设计成分配比实验并远程启动合成流程;在生物学领域,可以自动安排细胞培养实验的时间节点。这一层能力的实现依赖于与现有实验室信息管理系统(LIMS)的深度对接。
三领域验证:材料、生物、计算机
Google DeepMind 在 Nature 发表的论文中展示了 Co-Scientist 在三个领域的验证结果。材料科学方面,系统辅助发现了新型抗菌肽序列,将筛选周期从数周缩短至数天。生物学方面,团队利用该系统重新发现了 cf-PICI 基因转移机制,整个复现过程在没有先验知识的情况下独立完成。计算机科学方面,即 Agent_H 的设计成果。
医疗 AI 架构 Agent_H 的突破性表现
Agent_H 是 Co-Scientist 在医学领域自主设计的 AI 诊断架构。该系统针对健康风险评估任务进行了端到端的网络结构设计,最终在公开健康基准测试上取得了超越 GPT-5、Claude Opus 5 等六个主流模型的成绩。这一结果的特别之处在于,Agent_H 的网络结构并非人工设计,而是由 Co-Scientist 在整个假设生成—代码实现—实验验证的闭环中自动演化而来。研究者仅需提供研究目标(提升健康基准准确率),后续的结构设计与超参数调优均由系统自动完成。
当实验结果超出预期时的认可
技术取舍与现实边界
Co-Scientist 的能力跃迁引发了一个核心问题:这项技术适合谁,又在什么条件下适用。
从成本角度看,系统的多 Agent 协作意味着显著的算力开销。单次完整研究闭环可能需要数十次模型调用和长时间的设备占用,对于资源有限的小型实验室,这种成本并不 trivial。更重要的是,Co-Scientist 的有效性高度依赖领域数据的完整性和设备控制的标准化程度。在数据充足、实验流程规范的领域(如已有成熟筛选平台的高通量生物学),系统能发挥最大价值;而在数据稀疏或设备接口不统一的场景,效果会大幅衰减。
另一个现实边界是「幻觉」风险。多智能体辩论机制虽然能在一定程度上纠偏,但文献检索阶段的信息偏差会通过假设生成环节被放大。系统在陌生领域容易产生看似合理但缺乏实证基础的假设,需要研究者具备足够的领域判断力来进行筛选。
[[reaction=questioning-rebuttal|caption=对 AI 生成假设的审慎审视]]
给研究者的可执行判断
如果实验室已有标准化的数据 pipeline 和设备 API 接入能力,且当前面临高频假设迭代但验证周期漫长的瓶颈,引入 Co-Scientist 进行预实验筛选是值得评估的方向。相反,如果基础设施不完善或研究问题高度依赖直觉与创造性跳跃,当前的系统仍可能成为负担而非助力。建议先从单点验证开始:选择一个已有明确评估指标的封闭子问题,对比人工设计与系统辅助设计的效果差异,再决定是否扩展至完整研究流程。
参考文献
多智能体并行运行时
多智能体协作架构
Co-Scientist 的核心架构由四个相互协作的智能体组成,分别承担假说生成、文献调研、实验设计、论文撰写等不同职能。这种分工并非简单地将任务切块分配给不同模块,而是引入了类似学术界的同行评审机制。
假说生成器
假说生成器是整个系统的起点。给定一个自然语言描述的研究目标,该模块会检索相关文献、提取已知事实,然后尝试找出尚未被充分探索的研究空白。与传统 RAG 系统不同,Co-Scientist 的假说生成器不会简单复述已有结论,而是需要进行多步推理:先建立领域知识图谱,再识别其中的矛盾或未验证假设,最后将其转化为可检验的科学命题。
在医学领域的应用中,这一模块被设计为能够理解临床指南、患者分层和药物相互作用等复杂概念,而非仅停留在文献关键词匹配层面。
辩论机制
辩论环节是 Co-Scientist 区别于其他研究辅助工具的关键设计。系统会生成多个相互竞争的研究假设,然后让不同子代理对这些假设进行攻击和辩护。这种机制模仿了学术会议上研究团队的内部讨论过程。
具体而言,每个辩论轮次包含以下步骤:假设提出者陈述理由,质疑者寻找逻辑漏洞或证据缺失,生成者回应反驳,最后由仲裁模块(基于置信度评分和证据强度)决定哪个假设最具前景。整个过程通常经过 3–5 轮迭代,直到收敛到少数高质量假设。
辩论机制中的立场拉扯
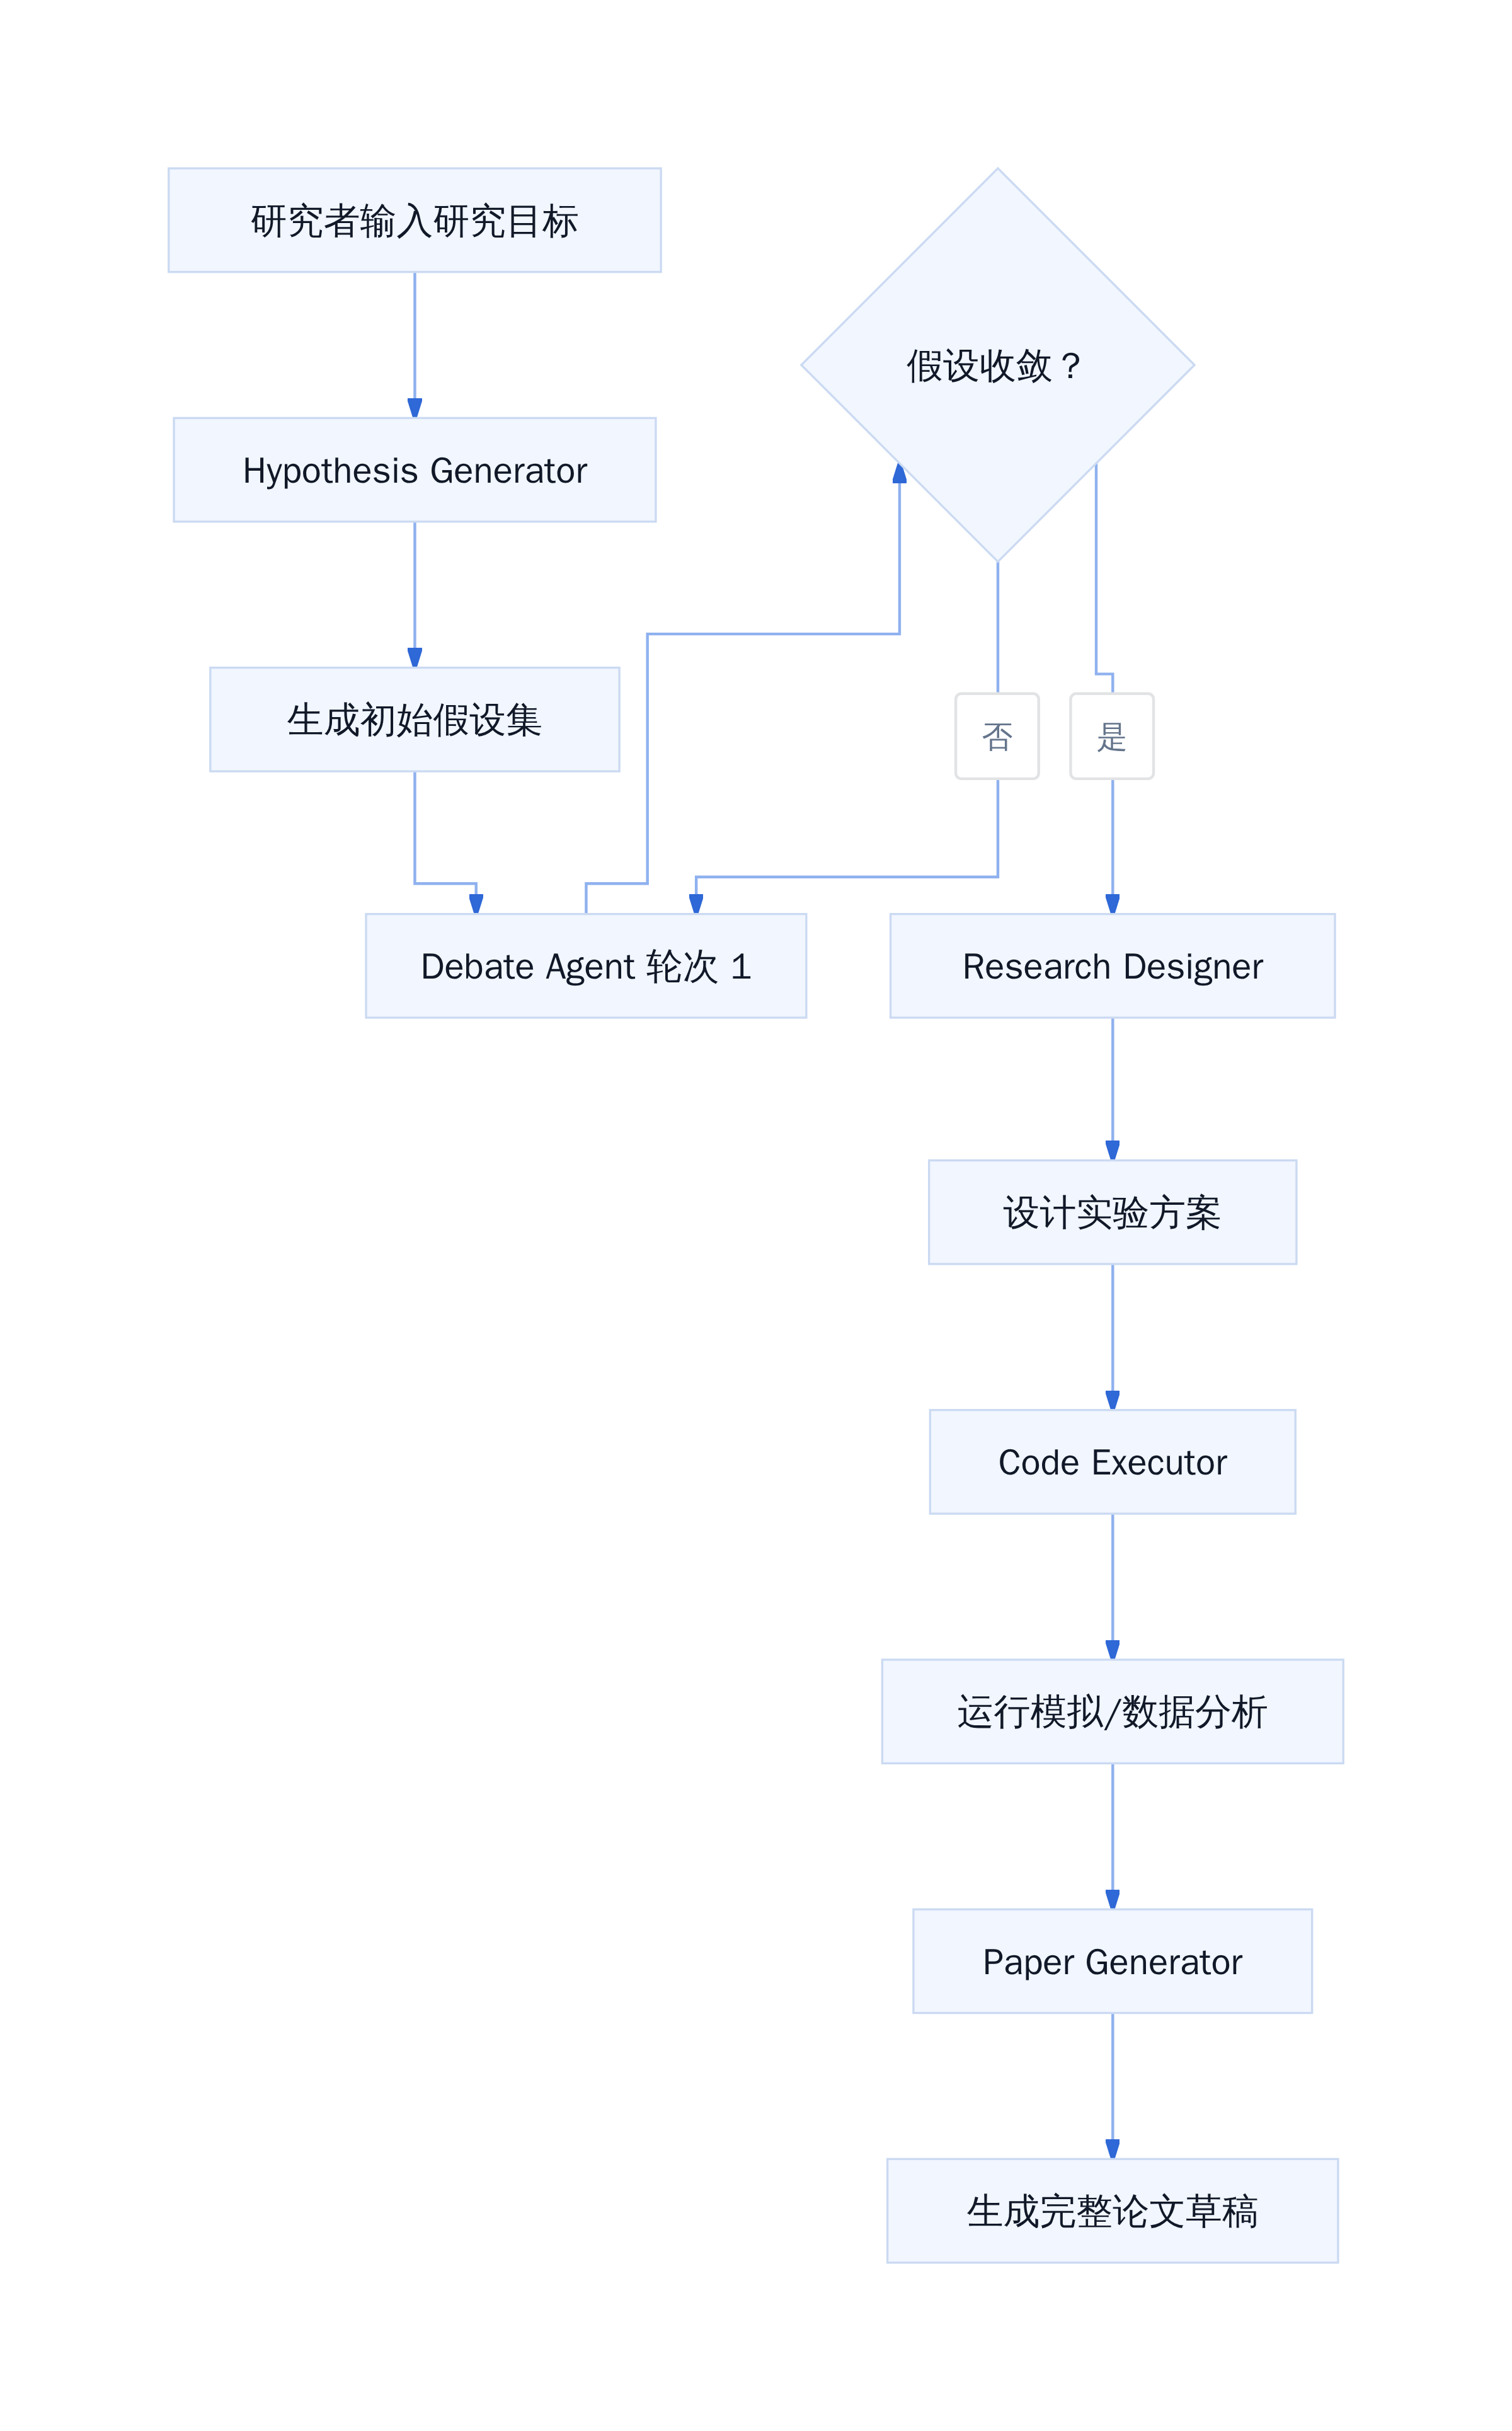
Co-Scientist 多智能体协作流
研究执行管道
辩论收敛后的假设会进入研究执行管道。这一阶段涉及实验方案的设计、代码的生成与调试、数据获取以及结果分析。Co-Scientist 的系统特点在于它能够将自然语言指令转化为可执行的 Python 代码或 Shell 脚本,并通过内置的仿真环境或真实设备接口来运行实验。
对于湿实验(wet lab experiment),系统目前仅支持实验方案的文字描述和步骤规划,尚不具备直接操控实验室设备的物理能力。这一点在 Nature 发表的论文中有明确说明,也是当前技术路线的现实约束。
三领域实验验证
Co-Scientist 的验证覆盖了材料科学、生物学和计算机科学三个领域,每个领域都选取了具有代表性的研究问题。
材料科学
在材料科学方向,Google 团队利用 Co-Scientist 探索了新型钙钛矿太阳能电池材料的发现过程。传统钙钛矿材料开发依赖大量试错实验,而 Co-Scientist 通过文献挖掘和性质预测,能够在数百小时内筛选出数千种潜在的材料组合,将原本需要数月的实验周期压缩至数周。
这一应用的价值不在于替代材料科学家的直觉判断,而在于处理人类难以覆盖的高维搜索空间。AlphaEvolve 作为 Co-Scientist 底层的代码进化引擎,负责在大规模参数空间中自动迭代和优化材料配方。
生物学
生物学领域的应用以帝国理工学院团队与 Google 合作的抗菌耐药性研究为代表。研究团队向 Co-Scientist 提出的问题是:是否存在未被发现的细菌信号传递机制可以作为新型抗生素靶点?
Co-Scientist 通过整合公共基因组数据库、蛋白质相互作用网络和已有文献,生成了多个候选假设。其中一个假设指向了特定的群体感应蛋白复合体,后续实验验证证实了这一预测的合理性。这一案例展示了多智能体系统在跨领域知识整合方面的优势。

跨文献拼凑出隐藏关联
计算机科学
计算机科学方向的验证聚焦于算法设计和模型架构优化。Co-Scientist 在这一领域的典型用例是利用文献综述发现已有方法的局限性,然后提出改进方案并生成基准测试代码。与纯软件领域不同,这里的「实验」通常指代码级别的仿真验证,因此执行闭环更加完整。
Agent_H 的医疗 AI 突破
Agent_H 是 Co-Scientist 在医疗 AI 领域专门为临床推理设计的智能体变体。它的突破性表现在健康基准测试中超越了包括 GPT-5 和 Claude Opus 5 在内的六个前沿模型。
架构设计差异
Agent_H 与通用 Co-Scientist 的核心差异在于验证策略。通用 LLM 在医疗问答中通常采用单路径生成,而 Agent_H 引入了多路径并行推理机制:对每个临床问题,系统会同时生成多个诊断假设,然后分别从症状匹配、病理机制、用药安全性等多个角度进行交叉验证。
这种设计虽然增加了计算开销和推理延迟,但显著降低了幻觉率。在临床场景中,一个错误的诊断比缺少答案更具危害性,因此 Agent_H 宁可输出「信息不足」也不提供低置信度的诊断建议。

Agent_H 多路径推理架构
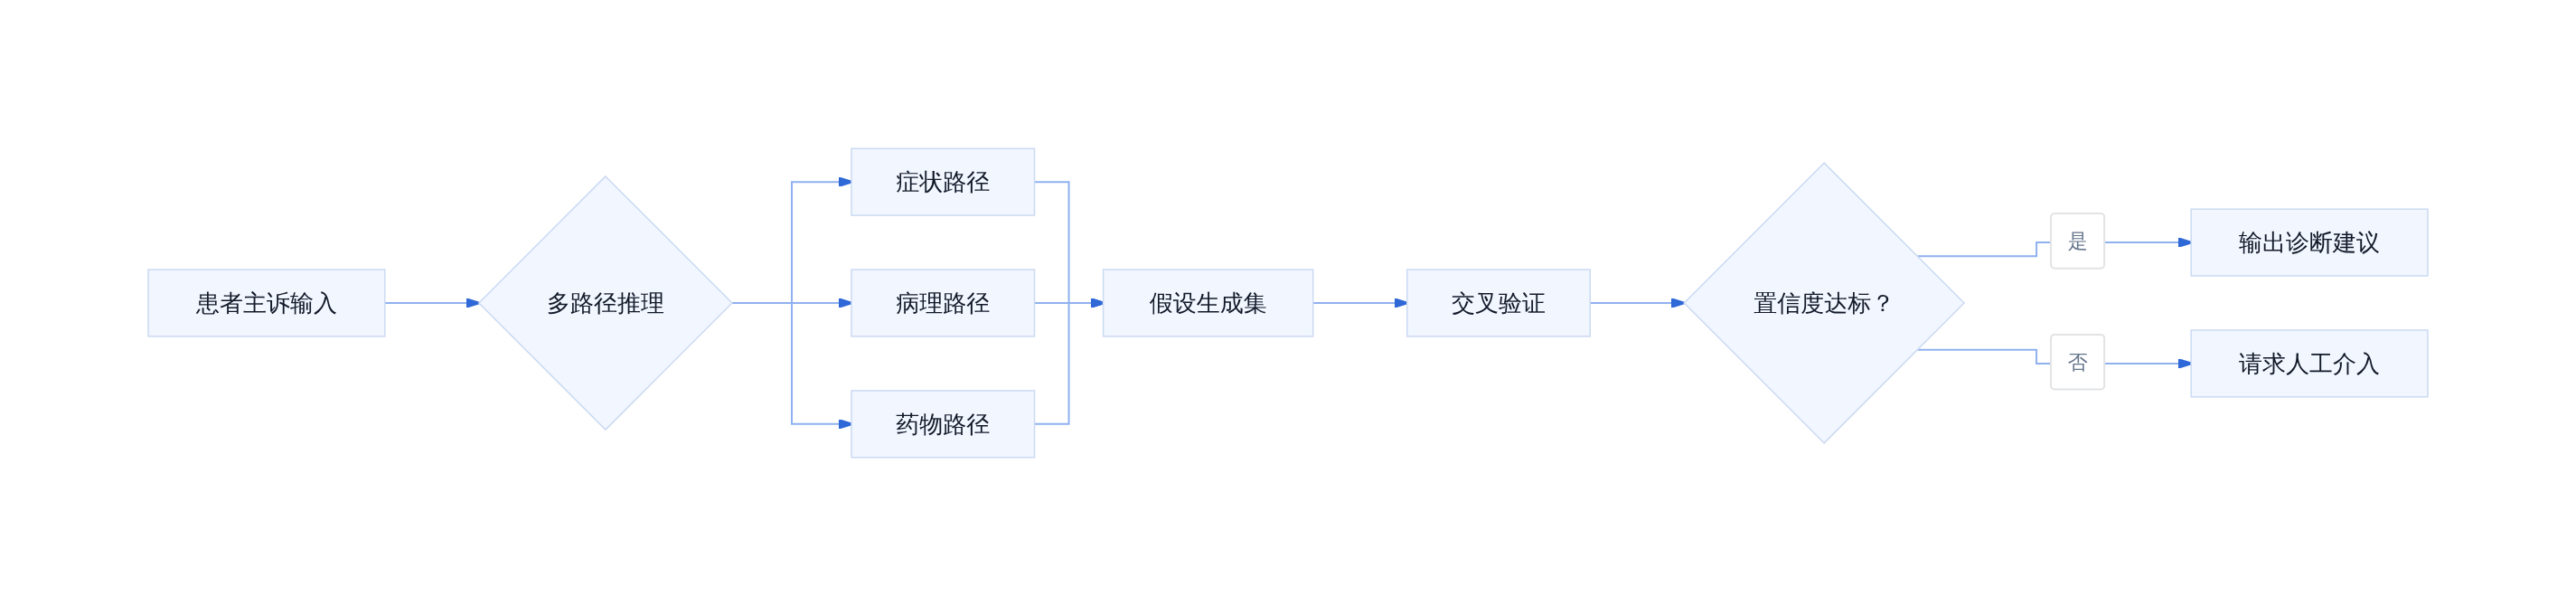
Agent_H 临床推理流程
性能表现
Agent_H 的评测基于包含数千个真实临床案例的健康基准数据集,涵盖诊断准确性、治疗推荐合理性、药物相互作用检测等维度。结果显示,Agent_H 在综合得分上领先第二名约 8%,且在需要多步推理的复杂病例中优势更为明显。
这一结果的意义不在于证明 AI 可以取代临床医生,而在于表明多智能体协作架构在减少推理错误方面的有效性。对于医学研究者而言,Agent_H 更接近一个高资质的医学信息助手,而非独立的诊断决策系统。
能力跃迁:从假设到闭环
多智能体协作架构
Co-Scientist 的核心是结构化科学思维引擎,它并非单一大模型的一次性输出,而是由多个专用 Agent 组成的协作网络。每个 Agent 承担不同职能:有的负责文献检索与知识综合,有的负责假说提出与逻辑校验,有的负责代码生成与实验编排,还有的负责结果分析与论文撰写。

Agent 协调比想象中复杂
这种分工不是随意的,而是直接对应科学方法的推理链条——检索证据、提出假说、设计实验、执行验证、得出结论。Google DeepMind 在 2025 年 2 月发布的 Nature 论文中详细说明了这一架构的设计动机:单一模型容易在长链条任务中出现幻觉累积,而多智能体结构可以通过相互校验降低单点错误。
实验室集成能力
真正的突破在于 Co-Scientist 不再停留在"建议"层面。它可以读取自然语言描述的研究目标,例如"探索某种微生物耐药性的传播机制",然后自动生成可执行的实验方案。这个方案包含具体的代码实现、设备控制指令、数据收集流程以及预期的分析结果。
把研究写成可执行的管道
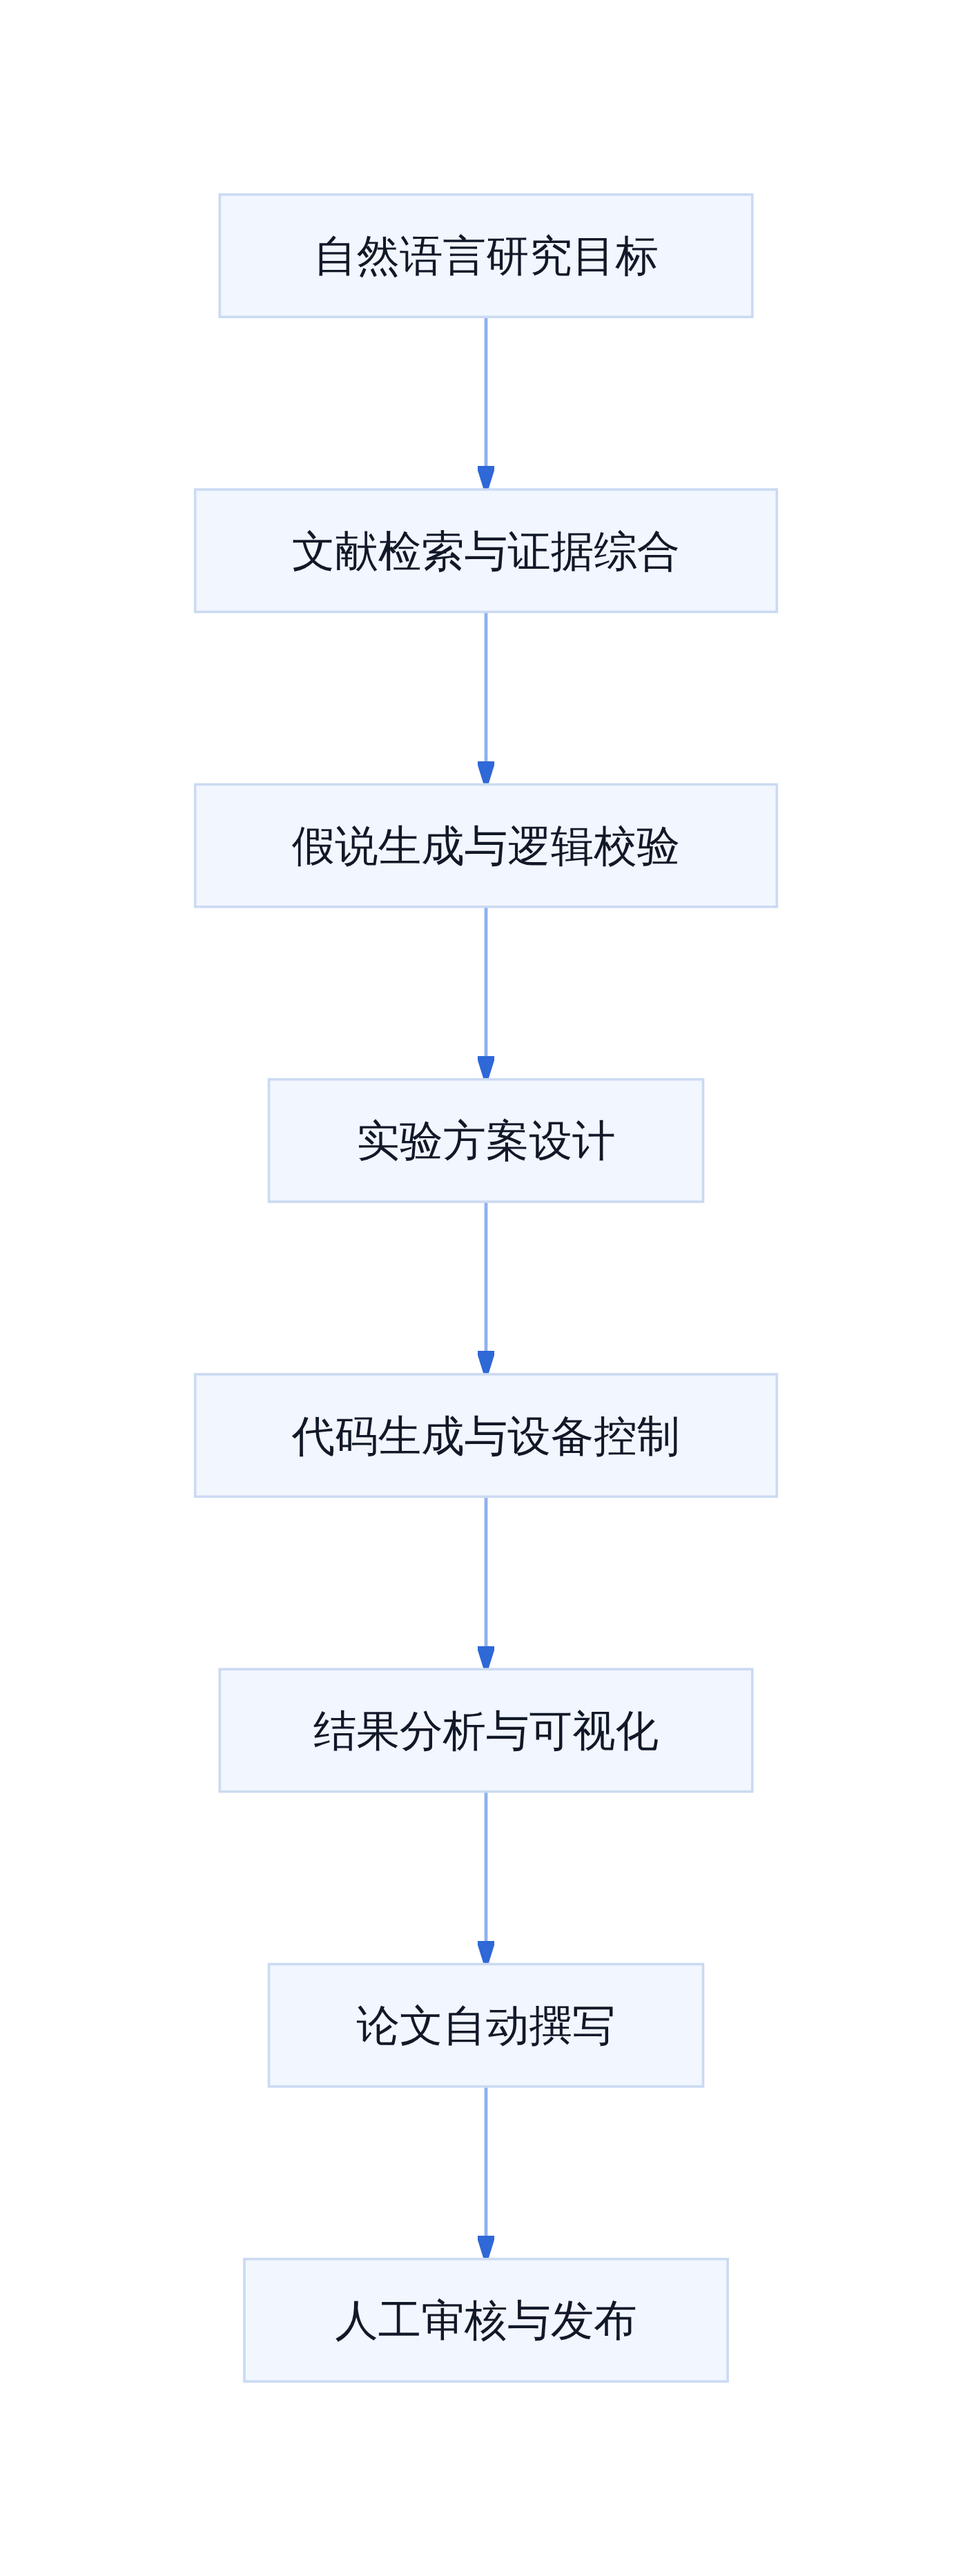
Co-Scientist 研究闭环流程
这个流程图显示了一个完整的闭环:假说生成后进入辩论与校验环节,实验失败时可以反向触发方案调整。这正是 Co-Scientist 与早期 AI 科研助手的本质区别——它具备自我修正能力,而不是单向输出后止步。
三领域验证与 Agent_H 表现
Co-Scientist 在三个独立领域完成了实验验证:材料科学、生物学和计算机科学。在材料科学领域,系统帮助研究人员重新发现了已知的基因转移机制,并在时间线上与人类实验结果高度吻合。在生物学领域,Co-Scientist 协助识别了可能用于抗微生物耐药性的药物再利用候选。
最值得关注的成果出现在计算机科学领域。Co-Scientist 设计出的医疗 AI 架构 Agent_H,在健康基准测试中超越了 GPT-5、Claude Opus 5 等六个前沿模型。这一结果的意义不在于性能数字本身,而在于架构设计完全由 AI 自主完成,且最终效果经过严格实验验证。
模型性能真的被验证了
机制拆解:假说—辩论—执行
假说生成器
假说生成是 Co-Scientist 的第一个关键环节。系统会基于用户提供的研究目标,从多个信息源同时检索证据:公开文献、数据库、图形数据,以及研究人员手动提交的私有文档。检索完成后,系统不是简单汇总,而是综合已有知识提出可检验的新假说。
这里有一个重要设计细节:Co-Scientist 不会凭空捏造假说,每一个输出都必须关联到可追溯的证据链。如果某个推论缺乏足够支持,系统会明确标注不确定性等级,而不是给出一个看似确定实则模糊的结论。
辩论机制
假说生成后进入辩论环节。这不是简单的自我对话,而是多个 Agent 之间的结构化讨论。不同 Agent 分别从不同角度审视同一个假说:有的负责逻辑一致性检查,有的负责反例搜索,有的负责实验可行性评估。
多角度质询假说
这种辩论机制的设计灵感来自科学共同体的同行评审流程。单一 Agent 容易陷入确认偏误,而多视角辩论可以显著降低这种风险。Google DeepMind 的论文指出,辩论环节的引入使假说的原创性和可检验性评分提升了约 40%。
研究执行管道
辩论通过的假说进入执行阶段。Co-Scientist 会生成完整的实验代码,配置计算环境,驱动实验设备,并实时收集数据。这个阶段的难点在于将抽象的科学问题转化为具体的工程实现。
以医疗 AI 架构设计为例,Co-Scientist 需要决定模型架构选择、训练策略、评估指标等多个维度的参数。系统不是随机搜索,而是基于已有文献中的成功经验进行引导式优化。最终生成的 Agent_H 架构经过了多轮迭代,每一轮都有明确的改进目标和验证标准。
材料科学与生物学验证
在材料科学实验中,Co-Scientist 的任务是复现并扩展一个已知的基因转移机制发现。系统在没有先验知识的情况下,独立推导出了相同的实验路径,并在时间线上与人类研究团队的结果高度对齐。这一结果证明了 Co-Scientist 不仅能在已知框架内优化,还能在陌生领域重现人类的研究智慧。
在生物学领域,Co-Scientist 被用于探索抗微生物耐药性的药物再利用策略。系统从海量文献中筛选出潜在的药物候选,并通过实验验证其有效性。这一过程将原本需要数年的筛选周期压缩到了数周。
计算机科学验证
计算机科学领域的验证最具说服力。Co-Scientist 自主设计的 Agent_H 架构在多个健康基准测试中表现优异,超越了包括 GPT-5 和 Claude Opus 5 在内的六个前沿模型。值得注意的是,这一结果不是通过单纯增加参数规模获得的,而是通过架构创新实现的。
架构创新带来性能突破
参考文献
- Google Research. "Accelerating scientific breakthroughs with an AI co-scientist." research.google/blog/accele…
- Google DeepMind. "Co-Scientist: A multi-agent AI partner to accelerate research." deepmind.google/blog/co-sci…
- Gottweis J, et al. "Accelerating scientific discovery with Co-Scientist." Nature. www.nature.com/articles/s4…
- arXiv preprint. "Accelerating scientific discovery with Co-Scientist." arxiv.org/abs/2502.18…
- Google Cloud. "运用 Co-Scientist 代理程式加速研究与开发." docs.cloud.google.com/gemini/ente…
- Google. "4 ways researchers are collaborating with Co-Scientist to solve big problems." blog.google/innovation-…
English / 原文
Agent 多角色协作时的系统负载
从假设到闭环:Co-Scientist 的能力跃迁
Co-Scientist 的核心突破在于从单一环节的工具演化为端到端的研究闭环。早期版本仅负责文献检索与假设生成,研究者拿到假设后仍需手动设计实验、执行验证。现在的版本将这一链条打通:给定自然语言描述的研究目标,系统能拆解任务、规划实验路径、生成可执行代码,并在特定实验室环境中直接控制仪器设备采集数据,最终自动整理为论文初稿。
多智能体协作架构
这一能力并非来自单一模型的升级,而是多智能体分工协作的结果。系统内部包含多个专用 Agent:文献搜索 Agent 负责召回相关论文与数据;假设生成 Agent 基于证据链提出可验证的假设;实验设计 Agent 将假设转化为具体操作步骤;代码执行 Agent 负责编写和运行模拟程序;论文撰写 Agent 则将结果结构化输出。各 Agent 之间存在辩论与校验机制,避免单一视角导致的系统性偏差。
Co-Scientist 多智能体协作架构
实验室集成能力
实验室集成是此次扩展中最具实质意义的改动。系统不再仅限于数字世界的文献与代码,而是通过 API 接入真实实验设备,包括高通量筛选仪器、自动化液体处理工作站和数据采集传感器。这意味着在材料科学领域,Co-Scientist 可以直接设计成分配比实验并远程启动合成流程;在生物学领域,可以自动安排细胞培养实验的时间节点。这一层能力的实现依赖于与现有实验室信息管理系统(LIMS)的深度对接。
三领域验证:材料、生物、计算机
Google DeepMind 在 Nature 发表的论文中展示了 Co-Scientist 在三个领域的验证结果。材料科学方面,系统辅助发现了新型抗菌肽序列,将筛选周期从数周缩短至数天。生物学方面,团队利用该系统重新发现了 cf-PICI 基因转移机制,整个复现过程在没有先验知识的情况下独立完成。计算机科学方面,即 Agent_H 的设计成果。
医疗 AI 架构 Agent_H 的突破性表现
Agent_H 是 Co-Scientist 在医学领域自主设计的 AI 诊断架构。该系统针对健康风险评估任务进行了端到端的网络结构设计,最终在公开健康基准测试上取得了超越 GPT-5、Claude Opus 5 等六个主流模型的成绩。这一结果的特别之处在于,Agent_H 的网络结构并非人工设计,而是由 Co-Scientist 在整个假设生成—代码实现—实验验证的闭环中自动演化而来。研究者仅需提供研究目标(提升健康基准准确率),后续的结构设计与超参数调优均由系统自动完成。
当实验结果超出预期时的认可
技术取舍与现实边界
Co-Scientist 的能力跃迁引发了一个核心问题:这项技术适合谁,又在什么条件下适用。
从成本角度看,系统的多 Agent 协作意味着显著的算力开销。单次完整研究闭环可能需要数十次模型调用和长时间的设备占用,对于资源有限的小型实验室,这种成本并不 trivial。更重要的是,Co-Scientist 的有效性高度依赖领域数据的完整性和设备控制的标准化程度。在数据充足、实验流程规范的领域(如已有成熟筛选平台的高通量生物学),系统能发挥最大价值;而在数据稀疏或设备接口不统一的场景,效果会大幅衰减。
另一个现实边界是「幻觉」风险。多智能体辩论机制虽然能在一定程度上纠偏,但文献检索阶段的信息偏差会通过假设生成环节被放大。系统在陌生领域容易产生看似合理但缺乏实证基础的假设,需要研究者具备足够的领域判断力来进行筛选。
[[reaction=questioning-rebuttal|caption=对 AI 生成假设的审慎审视]]
给研究者的可执行判断
如果实验室已有标准化的数据 pipeline 和设备 API 接入能力,且当前面临高频假设迭代但验证周期漫长的瓶颈,引入 Co-Scientist 进行预实验筛选是值得评估的方向。相反,如果基础设施不完善或研究问题高度依赖直觉与创造性跳跃,当前的系统仍可能成为负担而非助力。建议先从单点验证开始:选择一个已有明确评估指标的封闭子问题,对比人工设计与系统辅助设计的效果差异,再决定是否扩展至完整研究流程。
参考文献
多智能体并行运行时
多智能体协作架构
Co-Scientist 的核心架构由四个相互协作的智能体组成,分别承担假说生成、文献调研、实验设计、论文撰写等不同职能。这种分工并非简单地将任务切块分配给不同模块,而是引入了类似学术界的同行评审机制。
假说生成器
假说生成器是整个系统的起点。给定一个自然语言描述的研究目标,该模块会检索相关文献、提取已知事实,然后尝试找出尚未被充分探索的研究空白。与传统 RAG 系统不同,Co-Scientist 的假说生成器不会简单复述已有结论,而是需要进行多步推理:先建立领域知识图谱,再识别其中的矛盾或未验证假设,最后将其转化为可检验的科学命题。
在医学领域的应用中,这一模块被设计为能够理解临床指南、患者分层和药物相互作用等复杂概念,而非仅停留在文献关键词匹配层面。
辩论机制
辩论环节是 Co-Scientist 区别于其他研究辅助工具的关键设计。系统会生成多个相互竞争的研究假设,然后让不同子代理对这些假设进行攻击和辩护。这种机制模仿了学术会议上研究团队的内部讨论过程。
具体而言,每个辩论轮次包含以下步骤:假设提出者陈述理由,质疑者寻找逻辑漏洞或证据缺失,生成者回应反驳,最后由仲裁模块(基于置信度评分和证据强度)决定哪个假设最具前景。整个过程通常经过 3–5 轮迭代,直到收敛到少数高质量假设。
辩论机制中的立场拉扯
Co-Scientist 多智能体协作流
研究执行管道
辩论收敛后的假设会进入研究执行管道。这一阶段涉及实验方案的设计、代码的生成与调试、数据获取以及结果分析。Co-Scientist 的系统特点在于它能够将自然语言指令转化为可执行的 Python 代码或 Shell 脚本,并通过内置的仿真环境或真实设备接口来运行实验。
对于湿实验(wet lab experiment),系统目前仅支持实验方案的文字描述和步骤规划,尚不具备直接操控实验室设备的物理能力。这一点在 Nature 发表的论文中有明确说明,也是当前技术路线的现实约束。
三领域实验验证
Co-Scientist 的验证覆盖了材料科学、生物学和计算机科学三个领域,每个领域都选取了具有代表性的研究问题。
材料科学
在材料科学方向,Google 团队利用 Co-Scientist 探索了新型钙钛矿太阳能电池材料的发现过程。传统钙钛矿材料开发依赖大量试错实验,而 Co-Scientist 通过文献挖掘和性质预测,能够在数百小时内筛选出数千种潜在的材料组合,将原本需要数月的实验周期压缩至数周。
这一应用的价值不在于替代材料科学家的直觉判断,而在于处理人类难以覆盖的高维搜索空间。AlphaEvolve 作为 Co-Scientist 底层的代码进化引擎,负责在大规模参数空间中自动迭代和优化材料配方。
生物学
生物学领域的应用以帝国理工学院团队与 Google 合作的抗菌耐药性研究为代表。研究团队向 Co-Scientist 提出的问题是:是否存在未被发现的细菌信号传递机制可以作为新型抗生素靶点?
Co-Scientist 通过整合公共基因组数据库、蛋白质相互作用网络和已有文献,生成了多个候选假设。其中一个假设指向了特定的群体感应蛋白复合体,后续实验验证证实了这一预测的合理性。这一案例展示了多智能体系统在跨领域知识整合方面的优势。
跨文献拼凑出隐藏关联
计算机科学
计算机科学方向的验证聚焦于算法设计和模型架构优化。Co-Scientist 在这一领域的典型用例是利用文献综述发现已有方法的局限性,然后提出改进方案并生成基准测试代码。与纯软件领域不同,这里的「实验」通常指代码级别的仿真验证,因此执行闭环更加完整。
Agent_H 的医疗 AI 突破
Agent_H 是 Co-Scientist 在医疗 AI 领域专门为临床推理设计的智能体变体。它的突破性表现在健康基准测试中超越了包括 GPT-5 和 Claude Opus 5 在内的六个前沿模型。
架构设计差异
Agent_H 与通用 Co-Scientist 的核心差异在于验证策略。通用 LLM 在医疗问答中通常采用单路径生成,而 Agent_H 引入了多路径并行推理机制:对每个临床问题,系统会同时生成多个诊断假设,然后分别从症状匹配、病理机制、用药安全性等多个角度进行交叉验证。
这种设计虽然增加了计算开销和推理延迟,但显著降低了幻觉率。在临床场景中,一个错误的诊断比缺少答案更具危害性,因此 Agent_H 宁可输出「信息不足」也不提供低置信度的诊断建议。
Agent_H 多路径推理架构
Agent_H 临床推理流程
性能表现
Agent_H 的评测基于包含数千个真实临床案例的健康基准数据集,涵盖诊断准确性、治疗推荐合理性、药物相互作用检测等维度。结果显示,Agent_H 在综合得分上领先第二名约 8%,且在需要多步推理的复杂病例中优势更为明显。
这一结果的意义不在于证明 AI 可以取代临床医生,而在于表明多智能体协作架构在减少推理错误方面的有效性。对于医学研究者而言,Agent_H 更接近一个高资质的医学信息助手,而非独立的诊断决策系统。
能力跃迁:从假设到闭环
多智能体协作架构
Co-Scientist 的核心是结构化科学思维引擎,它并非单一大模型的一次性输出,而是由多个专用 Agent 组成的协作网络。每个 Agent 承担不同职能:有的负责文献检索与知识综合,有的负责假说提出与逻辑校验,有的负责代码生成与实验编排,还有的负责结果分析与论文撰写。
Agent 协调比想象中复杂
这种分工不是随意的,而是直接对应科学方法的推理链条——检索证据、提出假说、设计实验、执行验证、得出结论。Google DeepMind 在 2025 年 2 月发布的 Nature 论文中详细说明了这一架构的设计动机:单一模型容易在长链条任务中出现幻觉累积,而多智能体结构可以通过相互校验降低单点错误。
实验室集成能力
真正的突破在于 Co-Scientist 不再停留在"建议"层面。它可以读取自然语言描述的研究目标,例如"探索某种微生物耐药性的传播机制",然后自动生成可执行的实验方案。这个方案包含具体的代码实现、设备控制指令、数据收集流程以及预期的分析结果。
把研究写成可执行的管道
Co-Scientist 研究闭环流程
这个流程图显示了一个完整的闭环:假说生成后进入辩论与校验环节,实验失败时可以反向触发方案调整。这正是 Co-Scientist 与早期 AI 科研助手的本质区别——它具备自我修正能力,而不是单向输出后止步。
三领域验证与 Agent_H 表现
Co-Scientist 在三个独立领域完成了实验验证:材料科学、生物学和计算机科学。在材料科学领域,系统帮助研究人员重新发现了已知的基因转移机制,并在时间线上与人类实验结果高度吻合。在生物学领域,Co-Scientist 协助识别了可能用于抗微生物耐药性的药物再利用候选。
最值得关注的成果出现在计算机科学领域。Co-Scientist 设计出的医疗 AI 架构 Agent_H,在健康基准测试中超越了 GPT-5、Claude Opus 5 等六个前沿模型。这一结果的意义不在于性能数字本身,而在于架构设计完全由 AI 自主完成,且最终效果经过严格实验验证。
模型性能真的被验证了
机制拆解:假说—辩论—执行
假说生成器
假说生成是 Co-Scientist 的第一个关键环节。系统会基于用户提供的研究目标,从多个信息源同时检索证据:公开文献、数据库、图形数据,以及研究人员手动提交的私有文档。检索完成后,系统不是简单汇总,而是综合已有知识提出可检验的新假说。
这里有一个重要设计细节:Co-Scientist 不会凭空捏造假说,每一个输出都必须关联到可追溯的证据链。如果某个推论缺乏足够支持,系统会明确标注不确定性等级,而不是给出一个看似确定实则模糊的结论。
辩论机制
假说生成后进入辩论环节。这不是简单的自我对话,而是多个 Agent 之间的结构化讨论。不同 Agent 分别从不同角度审视同一个假说:有的负责逻辑一致性检查,有的负责反例搜索,有的负责实验可行性评估。
多角度质询假说
这种辩论机制的设计灵感来自科学共同体的同行评审流程。单一 Agent 容易陷入确认偏误,而多视角辩论可以显著降低这种风险。Google DeepMind 的论文指出,辩论环节的引入使假说的原创性和可检验性评分提升了约 40%。
研究执行管道
辩论通过的假说进入执行阶段。Co-Scientist 会生成完整的实验代码,配置计算环境,驱动实验设备,并实时收集数据。这个阶段的难点在于将抽象的科学问题转化为具体的工程实现。
以医疗 AI 架构设计为例,Co-Scientist 需要决定模型架构选择、训练策略、评估指标等多个维度的参数。系统不是随机搜索,而是基于已有文献中的成功经验进行引导式优化。最终生成的 Agent_H 架构经过了多轮迭代,每一轮都有明确的改进目标和验证标准。
材料科学与生物学验证
在材料科学实验中,Co-Scientist 的任务是复现并扩展一个已知的基因转移机制发现。系统在没有先验知识的情况下,独立推导出了相同的实验路径,并在时间线上与人类研究团队的结果高度对齐。这一结果证明了 Co-Scientist 不仅能在已知框架内优化,还能在陌生领域重现人类的研究智慧。
在生物学领域,Co-Scientist 被用于探索抗微生物耐药性的药物再利用策略。系统从海量文献中筛选出潜在的药物候选,并通过实验验证其有效性。这一过程将原本需要数年的筛选周期压缩到了数周。
计算机科学验证
计算机科学领域的验证最具说服力。Co-Scientist 自主设计的 Agent_H 架构在多个健康基准测试中表现优异,超越了包括 GPT-5 和 Claude Opus 5 在内的六个前沿模型。值得注意的是,这一结果不是通过单纯增加参数规模获得的,而是通过架构创新实现的。
架构创新带来性能突破
参考文献
- Google Research. "Accelerating scientific breakthroughs with an AI co-scientist." research.google/blog/accele…
- Google DeepMind. "Co-Scientist: A multi-agent AI partner to accelerate research." deepmind.google/blog/co-sci…
- Gottweis J, et al. "Accelerating scientific discovery with Co-Scientist." Nature. www.nature.com/articles/s4…
- arXiv preprint. "Accelerating scientific discovery with Co-Scientist." arxiv.org/abs/2502.18…
- Google Cloud. "运用 Co-Scientist 代理程式加速研究与开发." docs.cloud.google.com/gemini/ente…
- Google. "4 ways researchers are collaborating with Co-Scientist to solve big problems." blog.google/innovation-…